【2026年最新】ローカルLLMモデル一覧!自社に合う選び方と推奨スペック
自社のPCスペックや用途に合ったローカルLLMモデルを選ぶには、まずVRAM容量とライセンス条件を確認しておくと判断しやすくなります。
本記事では、クラウド型との違いやPCの動作要件から、汎用・コーディング向けなどの特徴別に分けた最新モデルの一覧までを解説します。
この記事の要約
- ローカルLLMは機密情報を外部に出さずに処理でき、従量課金なしでコストを抑えやすい
- VRAM容量が16GB〜24GBあれば、実業務で中規模モデルを動かす標準環境となる
- モデル選びでは商用利用ライセンスの有無と、自然な日本語処理能力の確認が重要である
- 目的に応じ、軽量なものや論理推論に長けたアーキテクチャのモデルを選択する
- 手軽に実行環境を構築するには、OllamaやLM Studioなどの専用ツールの導入が有効である
目次
なぜクラウド型ではなくローカルLLMモデルを選ぶのか
ローカルLLMには、クラウド型のLLM(生成AI)にはない明確な利点が存在します。ここから、導入によって得られる具体的な恩恵を観点別に示します。
| 観点 | 要点 |
|---|---|
| セキュリティ | 機密情報を外部サーバーに出さず安全に処理できる |
| コスト | APIの従量課金が発生せず定額で運用を維持できる |
| カスタマイズ性 | 自社の社内文書と連携させたRAG環境を構築できる |
機密情報を外部サーバーに出さず安全に処理できる
顧客データや未公開の社内情報を扱う場合、データが外部のサーバーに送信されないローカル環境での処理が有力な選択肢となります。クラウド型のAIは規約によって学習に利用されない設定が可能ですが、通信経路での漏洩リスクや心理的なハードルが残る課題がありました。自社内のPCやサーバーで完結するローカルLLMであれば、機密性の高い議事録や財務データも外部へ送信せずに要約できます。
利用頻度が高くてもAPIの従量課金コストが発生しない
毎日大量のテキストを処理する業務において、利用回数に応じた追加費用がかからない点は大きな強みといえます。クラウドAPIを利用して長文の処理や一括処理を繰り返すと、トークン数に応じた従量課金が膨れ上がる事態になりかねません。一度ハードウェアを整えてしまえば、モデルを何度呼び出しても電気代以外のランニングコストを低く維持できます。
自社専用の社内文書と連携させたRAG環境を構築できる
自社の業務マニュアルや過去の提案書を読み込ませ、独自の回答を生成するRAG(外部文書から関連情報を検索し回答生成に活用する技術)の構築に適しています。クラウド環境で大量の独自データを扱うと、データの同期やアクセス権限の管理が複雑になるという難点が存在しました。ローカル環境であれば社内ネットワーク内のファイルサーバーと直接連携し、安全かつ柔軟なAIシステムを構築しやすくなります。
【関連記事】
PCスペック(VRAM容量)で変わるローカルLLMの動作要件
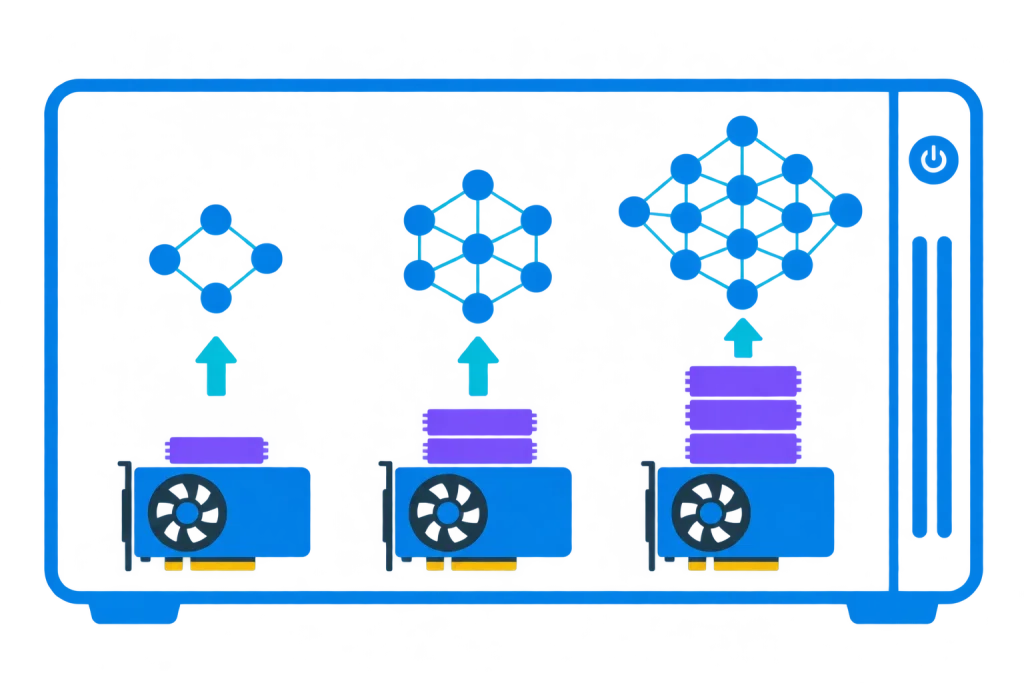
ローカルLLMを快適に動かすためには、グラフィックボードのVRAM(ビデオメモリ:映像処理専用のメモリ領域)容量が動作の鍵を握ります。PCのスペックに応じた実用的な用途の違いを分類します。
| VRAM容量の目安 | 実用的な用途 |
|---|---|
| 8GB〜12GB | 軽量モデルの実行や導入前の動作テストに留める |
| 16GB〜24GB | 実業務で中規模モデルを動かす標準環境とする |
| 32GB以上 | 大規模モデルの実行や独自の追加学習に活用する |
8GB〜12GB:軽量モデルの実行やテスト導入に留める
VRAMが8GBから12GBの環境では、パラメータ数が少ない軽量モデルの利用や、導入前の動作テストを主目的として考えます。この容量では量子化した軽量モデルが対象となり、コンテキストを広げるほどメモリ消費が増えるため長文の一括処理には不向きです。日常的な短い文章の要約や、プロンプトの基礎的な挙動を確認する用途であれば十分に機能します。
16GB〜24GB:実業務で中規模モデルを動かす標準環境とする
本格的な業務活用を見据える場合、16GBから24GBのVRAMを搭載した環境を標準的な基準として設定します。このクラスの容量があれば、汎用性が高く日本語処理にも優れた中規模のモデルをスムーズに実行可能です。ただし、極端に長い社内文書を一括で読み込ませるような処理では、メモリ不足でエラーになるケースもあります。
32GB以上:大規模モデルの実行やファインチューニングに活用する
高度な処理精度が求められるプロジェクトや、独自の追加学習を行う場合は、32GB以上のVRAMを前提に環境を設計します。30B級のモデルを量子化せずに動かすと58GB前後を消費するため、ファインチューニング(既存モデルに独自のデータを追加学習させ特定タスクに特化させる手法)まで見据える場合は複数GPUやサーバー級の構成も選択肢となります。初期投資の金額は高くなりますが、クラウド生成AIに依存しない高度な自社専用生成AIを構築する基盤となります。
自社に合うモデルはどう選ぶ?失敗しないための判断基準
数多くのモデルの中から自社の要件に合致するものを選ぶには、明確な基準を設けて比較検討する視点が役立ちます。選定時に確認すべきポイントを解説します。
| 確認項目 | 判断基準 |
|---|---|
| ライセンス | 商用利用が明示的に許可されているか確認する |
| 日本語精度 | 業務に耐えうる自然な日本語を出力できるか評価する |
| コンテキスト長 | RAG構築に必要な長文の処理に対応しているか見極める |
| アーキテクチャ | 推論速度に直結する内部構造の違いを把握して選ぶ |
商用利用が許可されたライセンス(Apache 2.0等)か確認する
自社の業務やサービスにモデルを組み込む際は、商用利用が明示的に許可されているライセンスを選ぶ必要があります。高性能なモデルであっても、研究用途に限定されているものを業務で利用すると、ライセンス違反に問われるリスクがあります。Apache 2.0やMITライセンスなど、ビジネスでの利用を広く認めている条件かどうかを事前に確認してから導入を進めるのが安全です。
参考:Apache License, Version 2.0 | Apache Software Foundation
参考:The MIT License – Open Source Initiative
業務で使える自然な日本語処理能力を備えているか評価する
モデルのパラメータ数やベンチマークのスコアだけでなく、実際の業務に耐えうる自然な日本語を出力できるかどうかが実用性を左右します。英語圏で開発されたモデルの中には、日本語の指示を正しく理解できても、出力される文章が不自然な直訳調になるものが少なくありません。日本語専用に学習されたモデルや、多言語対応が強化された最新モデルを優先してテストしておくと、導入後の手戻りを抑えやすくなります。
RAG構築に必要な長文のコンテキスト長に対応しているか見極める
社内文書を検索して回答を生成するRAGシステムを構築するなら、一度に処理できる文章の長さであるコンテキスト長を確認しておくことが重要です。コンテキスト長が短いモデルを選んでしまうと、複数のPDFやマニュアルを読み込ませた際に情報の一部が切り捨てられ、回答の根拠から漏れてしまいます。多くのモデルは公称のコンテキスト長よりも、実際に精度を保てる長さ(実効コンテキスト長)が短くなる傾向があります。入力を長くしすぎると、文章の中盤にある情報を取りこぼす「lost in the middle」と呼ばれる精度低下が起きる場合もあるため、32K以上に対応していることに加えて、長文を入力した際にも精度が維持されるモデルかどうかを確認することが重要です。
推論速度に直結するアーキテクチャ(Dense型かMoE型か)を把握する
実用的な応答速度を確保するために、モデルの内部構造であるアーキテクチャの違いを理解して選ぶ視点も求められます。従来のDense(高密度)型に対して、MoE型(入力データに応じて一部の計算回路のみを動かす仕組み)を採用したモデルは、少ないメモリで高速に動作するからです。PCのスペックに制限がある環境ほど、MoE型のモデルを選ぶ恩恵は大きくなります。
自社構築か搭載済みツールか:ローカルLLMの導入形態を用途から逆算する
モデルの選定基準を押さえたうえで、次に判断が必要になるのは「どこまでを自社で構築するか」という導入形態の設計です。同じローカル処理という要件でも、環境を自前で組むか、ローカルLLMを内蔵した業務ツールを使うかで、必要な工数と立ち上がりの早さが大きく変わります。
| 導入形態 | 向いているケース |
|---|---|
| 自社構築(モデル+実行環境) | 用途が定まらず幅広く検証したい、独自データで追加学習したい |
| ローカルLLM搭載ツール | 議事録や要約など用途が明確で、早期に業務成果を求めている |
モデル選定から運用までを自社で担う場合に発生する工数
自社構築では、モデルの比較検証に加えて、GPUの選定や量子化の調整、バージョン更新への追従といった継続的な運用業務が発生します。社内の利用者が増えるほど、端末ごとの動作差異やプロンプトの標準化、ナレッジ共有の仕組みづくりまで担当者の負荷が広がっていく構図です。 自由度の高さは大きな利点である一方、少人数の情報システム部門が本業と兼任で進める場合には、検証段階で止まってしまうリスクも考慮しておく必要があります。
ローカルLLMを内蔵した業務ツールで要件を満たす選択肢
用途が「機密情報を含む文書や会議の要約」に絞られている場合は、ローカルLLMをあらかじめ組み込んだ業務ツールを使う方が合理的です。モデルの選定やVRAM要件の見極めをベンダー側が済ませているため、担当者はインストールと運用ルールの整備に集中できます。 たとえばAI議事録ツールの分野では、PC内のローカルLLMで要約まで処理し、インターネット接続なしで完結する製品が実用段階にあります。自社構築と併用し、全社で使う定型業務から専用ツールに寄せる進め方が現実的です。
【関連記事】
汎用性と日本語精度に優れたローカルLLMモデル一覧
幅広い業務に適用でき、なおかつ自然な日本語のやり取りを得意とするモデルは、多くの企業で最初の導入候補となります。代表的なものを紹介します。
| モデル名 | 主な特徴 |
|---|---|
| Qwen3.6-35B-A3B | 高い言語理解能力と自然な日本語生成のバランスが良い |
| Gemma 4 26B-A4B | 限られたリソースでも動作し特定のフォーマット処理に優れる |
| Nemotron 3 Nano | 応答の待ち時間が短く滑らかな対話に特化している |
Qwen3.6-35B-A3B
総パラメータ35B・アクティブ3BのMoE構成で、文章作成から要約まで幅広くこなす中規模モデルです。テキストに加えて画像や動画も扱えるネイティブマルチモーダル設計で、262Kトークンの長文コンテキストにも対応しています。メールの文面作成や社内向けの報告書を整えるような、一般的な事務作業の補助に威力を発揮します。
参考:Qwen3.6-35B-A3B | NVIDIA NGC
Gemma 4 26B-A4B
比較的コンパクトなサイズでありながら、最新のアーキテクチャを採用して高い処理性能を実現している点が特徴といえます。アクティブパラメータが4Bに抑えられており、4bit量子化版を使えばVRAMが24GB程度のPC環境にも導入できるモデルです。複雑な指示に対する追従性も高く、特定のフォーマットに従ったデータ抽出などのタスクを安定して処理できます。
参考:Gemma 4 モデルの概要 | Google AI for Developers
Nemotron 3 Nano
独自のハイブリッド構造(Mamba-TransformerにMoEを組み合わせた設計)によって推論スピードを引き上げた、総パラメータ31.6B・アクティブ3.2Bの軽量モデルに位置づけられます。応答の待ち時間が非常に短いため、チャットボットのバックエンドやリアルタイム性を重視するアシスタントツールに適しています。コーディングや数学、長文処理のベンチマークでは同規模帯のモデルを上回る精度を示しており、業務上の調査や推論タスクにも対応できます。
参考:Nemotron AI Models | NVIDIA Developer
コーディングと論理推論に特化したローカルLLMモデル
システム開発の補助や、複雑なロジックを読み解くタスクにおいては、プログラミングコードの生成や数学的推論に強みを持つモデルが活躍します。用途に合った選択肢を提示します。
| モデル名 | 主な特徴 |
|---|---|
| DeepSeek V4 Flash | 高速なコード生成やバグの修正提案に秀でている |
| Qwen3 Coder Next | 複雑なシステム要件をもとにした高度な論理推論を得意とする |
| Laguna S 2.1 | 長い文脈を途切れることなく保持し正確なコードを出力する |
DeepSeek V4 Flash
プログラミング言語の文法やライブラリの知識を豊富に学習しており、高速なコード生成やバグの修正提案に秀でたモデルです。推論のプロセスが最適化されているため、長大なソースコードを読み込ませても迅速にエラーの原因を特定する能力を備えています。総パラメータ284B・アクティブ13Bという構成のため、社内で動かす場合はサーバー級のGPU環境を用意する前提となります。
参考:DeepSeek | DeepSeek-V4 Preview: Entering the Era of Affordable Million-Token Context
Qwen3 Coder Next
単なるコードの自動補完にとどまらず、リポジトリ全体を操作しながら修正を進めるコーディングエージェント向けに設計されたモデルです。総パラメータ80B・アクティブ3Bの構成でSWE-Bench Verifiedで70%超を記録しており、低い推論コストで実務的な開発支援をこなせます。アルゴリズムの設計や、既存のレガシーコードを最新の言語に書き換える作業に導入すると効果的です。
参考:Qwen
Laguna S 2.1
非常に長い文脈を途切れることなく保持し、ドキュメント全体を通した整合性の高い推論を実行する能力に特化しています。数万行に及ぶAPIリファレンスや仕様書を一度に入力し、その内容に基づいた正確なコードを出力できるのが大きな強みです。高い推論能力を引き出すためには相応のVRAM容量を要求されるため、実行環境のスペックには余裕を持たせる必要があります。
参考:Poolside
低スペックPCでも動作する軽量なローカルLLMモデル
ハイスペックな専用マシンを用意できない場合でも、パラメータ数を抑えた軽量モデルを選べば十分にAIの恩恵を受けられます。ノートPC等でも動かしやすいモデルを挙げます。
| モデル名 | 主な特徴 |
|---|---|
| Phi-4 | 大規模モデルに迫る論理的思考力を持ちノートPCでも動く |
| Qwen3-1.7B | 処理の軽さと応答速度を最優先にチューニングされている |
| Ministral 3 | ビジネス文書の校正など頻出タスクに処理能力を集中させている |
Phi-4
驚くほど少ないパラメータ数でありながら、厳選された質の高いデータで学習することで、大規模モデルに迫る論理的思考力を備えています。14Bのパラメータ数で単一GPUでの実行を想定した設計のため、4bit量子化版を使えばVRAM8GB〜12GB程度の端末にも導入できます。高度な専門知識の引き出しには限界があるものの、テキストの要約や構造化といった基本的な情報処理タスクであれば高い精度を発揮します。
参考:microsoft/phi-4 · Hugging Face
Qwen3-1.7B
総パラメータ1.7Bという極めて軽量な設計でありながら、100以上の言語に対応し日本語の生成もこなせるモデルです。リソースが限られたローカル環境や低スペックなPCでの実行に向いており、処理の軽さと応答速度を重視してチューニングされています。シンプルな応答や単語の抽出など、タスクを限定して利用することで、動作の軽快さを最大限に活かせます。
参考:Qwen/Qwen3-1.7B · Hugging Face
Ministral 3
限られたメモリ環境でも安定して動作し、日常的な業務サポートをこなせる汎用性を維持したバランスの良い軽量モデルです。ネイティブの関数呼び出しや画像の解析にも対応しつつ、ビジネス文書の校正や翻訳といった頻出タスクを安定してこなせます。最大256Kトークンのコンテキストに対応しているため、長めの社内文書を読み込ませるワークフローにも組み込めます。
参考:mistralai/Ministral-3-8B-Instruct-2512 · Hugging Face
ローカルLLMを手軽に動かすための推奨ツール
モデル本体をダウンロードしただけではAIを利用できません。複雑な設定を省き、簡単な操作でローカルLLMを実行できる代表的なソフトウェアを紹介します。
| ツール名 | 主な特徴 |
|---|---|
| Ollama | コマンドラインからの短い命令でモデルのダウンロードから実行を行える |
| LM Studio | 画面上のボタン操作だけでモデルの切り替えやパラメータ調整が完結する |
Ollama
コマンドラインから短い命令を入力するだけで、モデルのダウンロードから実行までを自動的に行える非常に手軽なツールです。macOSやWindows、Linuxに対応し、ローカル実行とクラウド上のモデル実行を同じ操作で切り替えられる仕組みを持っています。外部のアプリケーションと連携させるAPIサーバーとしての機能も内蔵しているため、自社開発のシステムに組み込む際の基盤としても重宝します。
参考:Ollama
LM Studio
直感的な操作画面を備え、ブラウザで検索するような感覚でモデルを探してチャット機能を利用できるソフトウェアです。コマンド入力に不慣れな担当者であっても、画面上のボタン操作だけでモデルの切り替えやパラメータの調整が完結するからです。自身のPCスペックでどのモデルが動くのかを自動で判定してくれる機能もあり、初めてローカルLLMに触れる方でも扱いやすいツールの一つです。
参考:LM Studio Bionic – Agent for Work and Code
議事録作成での利用ならローカルLLM搭載のAI議事録ツール
ここまで、用途に応じたローカルLLMモデルの一覧や、手軽に実行環境を構築するためのツールをご紹介してきました。しかし、もしローカルLLM導入の最大の目的が「会議の議事録作成や要約」である場合、一から自社でモデルを選定し環境を構築するのは、システム担当者にとって大きな負担となります。機密保持の観点からローカル環境を求めている場合は、音声認識AIとローカルLLMが内蔵された専用ツールから検討を始めると、立ち上がりが早くなりやすいといえます。
完全オフラインで情報漏洩を徹底的に防ぐ「ScribeAssist」
経営会議や未公開のプロジェクトなど、機密性の高い情報を扱う業務において、安全に文字起こしから要約までを完結させたい場合におすすめなのが、スタンドアローン型のAI議事録作成ツールである「ScribeAssist(スクライブアシスト)」です。
インターネット接続が不要なオフライン環境で動作するため、外部のサーバーへ音声やテキストデータが送信されることによる情報漏洩リスクを大幅に抑えられます。複雑なモデル選定や動作テストを行わなくても、動作要件を満たすPCにインストールすれば音声認識とローカルLLMによる自動要約を使い始められる点が、自社構築と比べた利点といえます。
「ScribeAssist」についての詳細資料
自社のPCスペックやセキュリティ基準、そして実際の業務フローに対して、どのツールが最も適しているかを見極めるためには、具体的な機能や動作要件の比較検討が欠かせません。
機密情報を守りながら業務の自動化を推進するAI議事録ソリューションについて、さらに詳しい機能や導入事例を知りたい方は、ぜひ以下の資料をダウンロードしてご活用ください。失敗しないAI環境構築のためのヒントをご確認いただけます。
まとめ
自社のPCスペックや用途に合ったローカルLLMモデルを選ぶためには、VRAM容量の把握と商用利用ライセンスの確認が重要になります。日本語精度の高さや推論速度を左右するアーキテクチャの違いを見極め、目的に応じて軽量モデルと大規模モデルを使い分ける視点が求められます。
そのうえで検討したいのが、モデルを自社で組み合わせて構築する範囲と、ローカルLLMを組み込んだ既製ツールに任せる範囲の線引きです。社内全体で横断的に使う汎用チャット環境は自社構築、議事録のように要件が固まっている定型業務は専用ツール、という切り分けであれば、検証の工数を抑えながら早期に成果を出せます。
議事録業務をオフラインで完結させたい場合は、文字起こしから要約までをPC内で処理する「ScribeAssist」の仕様や対応スペックを資料で確認し、14日間の無料トライアルで自社の端末での動作を試してみてください。
問い合わせ
https://voxt-one.advanced-media.co.jp/inquiry/