ローカルLLMの性能はクラウドLLMに劣る?実用PCスペックとメリット
ローカルLLMの性能は、用途を絞ったチューニングや外部データとの連携を組み合わせることで、クラウド型AIに近い実務レベルの精度を発揮するケースもあります。本記事では、クラウドLLMとの性能の違いから、実用的なレスポンスを得るために必要なPCスペック、企業への導入メリットまでを整理します。
この記事の要約
- 汎用タスクはクラウドLLMが有利だが、特定業務に特化させればローカルLLMが勝る
- 機密情報を外部に出さないため、高セキュリティな環境で生成AIを利用できる
- VRAM 12GB〜24GB以上のGPUを用意することで、業務実用に耐える応答速度を実現できる
- Qwen3のように日本語を含む多言語処理に強いモデルなど、ビジネスで使いやすい高性能なオープンモデルが揃っている
- 社内ドキュメントの検索や、オフライン環境での議事録作成などで活用が進んでいる
目次
ローカルLLMとクラウドLLMの性能はどう違うのか
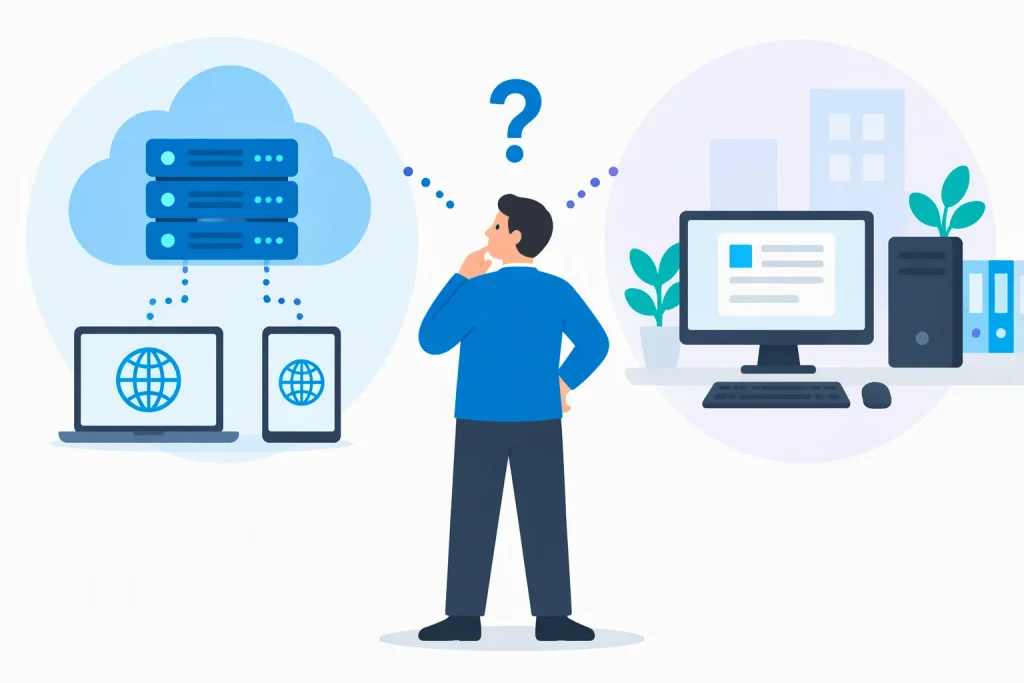
ローカルLLMとクラウドLLMは、処理できるタスクの幅や応答速度の決まり方に明確な違いがあります。それぞれの特徴を整理します。
| 観点 | ローカルLLMの特徴 |
|---|---|
| 汎用タスク | クラウド型の大規模モデルに劣る傾向がある |
| 特定業務 | RAGや追加学習でチューニングすればクラウド型を上回る |
| 応答速度 | 導入するPCのGPUやVRAMのスペックに大きく依存する |
汎用的な回答精度や複雑な推論タスクでは大規模なクラウドLLMが優位に立つ
幅広い知識を問う質問や、複雑な論理推論などの汎用タスクにおいては、ChatGPTなどのクラウドLLMが優位に立ちます。クラウドLLMは数千億以上のパラメータ(AIの脳の規模を示す指標)を持つ巨大なモデルを、データセンターの巨大な計算資源で動かしています。ローカル環境で動かせる軽量モデルはパラメータ数が少なく、あらゆる質問に高精度で答える用途には向きません。一方で、これはローカルLLMが業務で使えないという話ではありません。
特定業務に特化させたチューニングやRAG連携ではローカルLLMが勝る
社内規定の検索や特定のフォーマットでの文章作成など、用途を限定した業務においてはローカルLLMが実力を発揮します。自社の専門用語を追加学習させたり、RAG(外部データベースから関連情報を検索して回答を生成する技術)と連携させたりすることで、正確な回答を引き出せます。目的を絞り込めば、軽量モデルでも巨大モデルと同等以上の成果を出せるといえます。
応答速度は導入するGPUやVRAMのスペックに大きく依存する
ローカルLLMのテキスト生成スピードは、動かすPCのハードウェア性能によって決まります。特に重要なのがGPU(画像処理や並列計算に特化した演算装置)の性能と、GPUに搭載されているVRAM(ビデオメモリ)の容量です。十分なVRAMを確保してモデル全体をGPUに読み込ませることができれば、人間が読むよりも速いスピードで文章を生成できます。
企業がローカルLLMを導入する4つのメリット
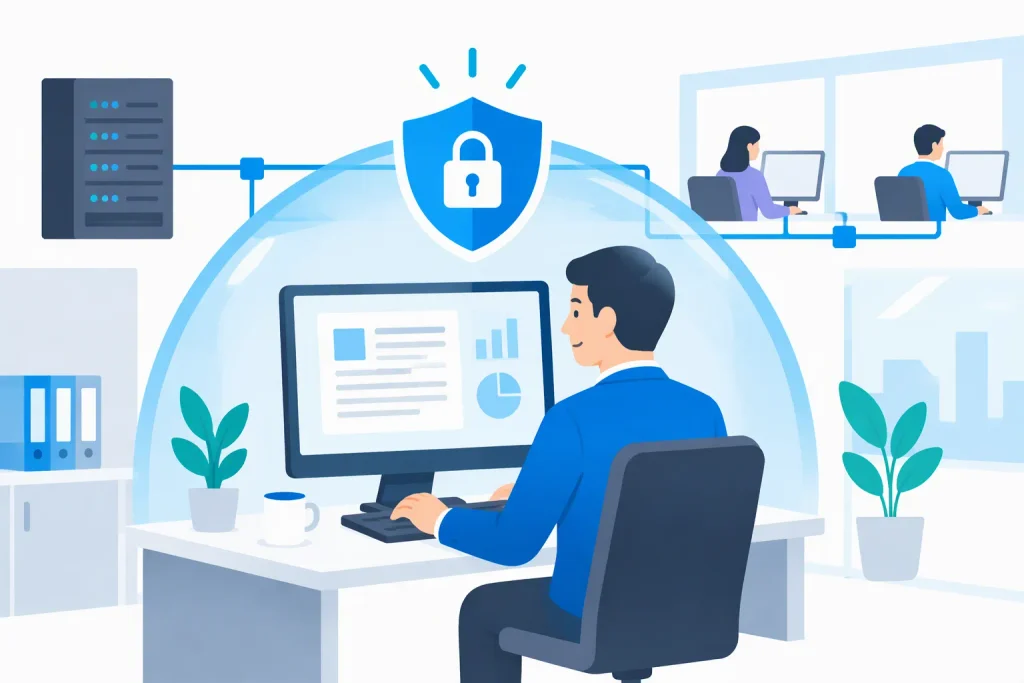
クラウドLLMにはない、自社運用ならではの利点が存在します。導入によって得られる効果を整理します。
| メリット | 具体的な効果 |
|---|---|
| セキュリティ | 機密情報を外部サーバーに送信せず安全に処理できる |
| コスト削減 | 従量課金が発生せず、利用回数が増えても費用が固定される |
| 安定稼働 | オフラインで動作し、通信障害や運営会社の仕様変更に影響されない |
| カスタマイズ性 | 自社の業務フローに合わせて倫理フィルターの制限なく開発できる |
機密情報や顧客データを外部サーバーに送信せず安全に処理できる
大きなメリットは、社外秘のドキュメントや顧客の個人情報を自社ネットワーク内で処理できることです。入力したデータが外部のサーバーに送信されないため、外部送信に伴う情報漏洩リスクを大幅に抑えられます。金融機関や医療機関など、クラウドサービスの利用制限が厳しい業界でも、安全に生成AIを活用した業務効率化を進められます。
利用回数やトークン消費量に応じたクラウドの従量課金コストを削減できる
一度ハードウェアを構築してしまえば、その後は何度使っても追加のAPI利用料やサブスクリプション費用が発生しません。クラウドLLMを全社規模で導入したり、大量のテキストデータを処理させたりすると、トークン(AIが文章を処理する最小単位)の消費量が膨大になり、毎月のコストが跳ね上がります。利用頻度が高い業務ほど、ローカルLLMのコストメリットが大きくなると考えられます。
運営会社の仕様変更や通信障害の影響を受けずオフラインでも安定稼働する
インターネット接続が不要なため、完全なオフライン環境でもAIを利用できます。クラウドサービスで起こり得る通信障害や、運営会社側のサーバーダウンによる業務停止リスクを回避する手段になります。クラウドLLM特有の突然のモデルアップデートや仕様変更に振り回されることなく、検証済みのモデルを使い続けることが可能です。
自社の業務フローに合わせて倫理フィルターの制限なく自由にカスタマイズできる
オープンソースとして公開されているモデルを利用するため、自社の要件に合わせた自由な調整が可能です。クラウドLLMに組み込まれている強力な安全基準や倫理フィルターによって、業務上必要な回答がブロックされてしまう事態を防げます。専門分野の用語学習や特定の出力形式への固定など、業務フローに最適化したAI環境を構築できます。
【関連記事】
運用前に把握すべきローカルLLMのデメリット
独自のAI環境を構築するにあたり、コストや運用面での負担が発生します。導入前に想定すべき懸念点を整理します。
| 懸念点 | 運用の実態 |
|---|---|
| 初期投資 | 高価なGPUやサーバー機材の購入費用がかかる |
| 保守管理 | モデルのアップデートやハードウェアの管理を自社で行う |
| 精度低下 | スペック不足の環境ではAIの幻覚が起きやすくなる |
実用的なレスポンスを得るために高価なGPUなどの初期投資が求められる
業務でストレスなく利用できる速度を出すためには、高性能なGPUを搭載したPCやサーバーの導入が求められます。AIの推論処理に特化したハイエンドのグラフィックボードは単体で数十万円から数百万円のコストがかかります。クラウドLLMのような従量課金は発生しませんが、初期段階でまとまったハードウェア投資が必要になります。
最新モデルへのアップデートやハードウェアの保守を自社で対応する必要がある
AIモデルの選定やダウンロード、システムの構築、トラブルシューティングまですべて自社で対応する技術力が求められます。生成AIの技術進化は非常に速いため、定期的に新しいモデルを検証し、システムをアップデートする運用体制を整えなければなりません。ハードウェアの故障に対する保守メンテナンスの負担も発生します。
スペック不足の環境ではハルシネーションが起きやすくなる
PCのスペックが足りない状態で無理にモデルを動かそうとすると、処理を軽くするためにモデルを圧縮する「量子化」を強くかける必要が出てきます。過度な量子化はAIの賢さを損ない、不正確な情報を自信満々に答えるハルシネーション(AIの幻覚)を増加させます。実用的な精度を保つには、モデルのサイズに見合ったハードウェアリソースを確保することが重要です。
実用的な性能を引き出すPCスペックの目安
ローカルLLMを動かすために必要なハードウェア要件は、使用するモデルの規模によって変わります。想定用途ごとの推奨スペックを整理します。
| 想定用途 | 推奨VRAM・メモリ |
|---|---|
| 軽量モデル(7B〜8Bクラス)の実行 | 4bit量子化ならVRAM 6〜8GBから動作、快適に使うならVRAM 12GB以上のGPU |
| 業務用の高精度モデル(14B〜32Bクラス)の実行 | 14Bクラスは4bit量子化でVRAM 10〜12GB程度から、32Bクラスは20〜24GB程度必要のためVRAM 24GB以上のGPU |
| モデルの読み込み遅延防止 | 32GB以上のメインメモリ |
軽量モデルを動かすならVRAM 12GB以上のGPUを用意する
パラメータ数が7B(70億)から8B前後の軽量モデルを動かす場合、4bit量子化モデルであればVRAM 6〜8GB程度のGPUでも動作可能で、快適に使うならVRAM 12GB以上のGPUが望ましいとされています。このクラスのGPUであれば、一般的なデスクトップPCにも搭載しやすく、初期投資を抑えられます。簡単なテキスト要約やコード生成であれば、このスペックでも実用的なスピードで動作します。
業務用の高精度モデルを扱うならVRAM 24GB以上を確保する
より複雑な指示に対応できる14Bから32Bクラスの中規模モデルを動かす場合、14Bクラスなら4bit量子化でVRAM 10〜12GB程度から動作しますが、32Bクラスでは4bit量子化でも20〜24GB程度が必要となるため、VRAM 24GB以上のGPUが推奨されます。
VRAMが不足すると、処理の一部を通常のメインメモリに回すことになり、生成速度が極端に低下します。本格的なRAGシステムを構築したり、高精度な翻訳を行ったりする場合は、このクラスのVRAMを確保したハイエンドGPUを選定します。
モデルの読み込み遅延を防ぐために32GB以上のメインメモリを積む
GPUの性能だけでなく、PC本体のメインメモリ(RAM)も32GB以上を搭載しておくのが安全です。サイズの大きいAIモデルをストレージから読み込んだり、大量のドキュメントを並行して処理したりする際に、メインメモリが少ないとシステム全体が重くなります。GPUのVRAM容量だけでなく、ベースとなるPCのメモリも余裕を持たせることが安定稼働の条件です。
用途に合わせて選ぶおすすめのローカルLLMモデル
現在、世界中の企業や研究機関から様々なオープンモデルが公開されています。ビジネスで使いやすく、日本語環境での利用も検討しやすい代表的なモデルを整理します。
| モデル名 | 特徴 |
|---|---|
| Llama 4 | Meta社が開発したマルチモーダル対応で汎用性の高いモデル |
| Gemma 4 | Google社が提供する軽量サイズから選べる高効率なモデル |
| Qwen3 | アリババ社が開発した多言語とコーディングに強いモデル |
Llama 4
Meta社がLlama 4コミュニティライセンスのもとで公開している、テキストと画像を同時に扱えるネイティブマルチモーダルモデルです。軽量な「Scout」(17B・16エキスパート構成)と高性能な「Maverick」(17B・128エキスパート構成)が提供されており、用途やPCスペックに合わせて選択できます。200言語のデータで事前学習されており、ファインチューニングの対応を公式に表明している言語はアラビア語・英語・ドイツ語・スペイン語・ヒンディー語など12言語です。なお、ローカル環境で軽量に動かしたい場合は、70BのLlama 3.3や8BのLlama 3.1といった前世代のテキストモデルも引き続き選択肢になります。
参考:The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation
Gemma 4
Google社がGeminiモデルと同じ研究と技術をもとに開発した、軽量で効率的なオープンモデルです。E2B・E4B・12B・26B A4B・31Bの5サイズが提供されており、スマートフォンやノートPCからワークステーションまで、環境に合わせて選べます。コンテキスト長はE2B・E4Bが128K、それ以上のサイズが256Kに対応しており、VRAMが限られた環境でも軽快に動作します。
参考:Gemma 4 モデルカード | Google AI for Developers
Qwen3
アリババ社が開発したモデルで、日本語を含む119の言語・方言に対応している点が特徴です。0.6B・1.7B・4B・8B・14B・32Bの密モデルと、30B-A3B・235B-A22BのMoEモデルが公開されており、VRAM容量に合わせて選びやすい構成です。じっくり推論する「思考モード」と即答する「非思考モード」を切り替えられ、複雑な論理的推論やプログラミングコードの生成タスクで優れた成績を残しています。社内の開発エンジニア向けのコーディング支援ツールとしてローカルLLMを構築する際に、高いパフォーマンスを期待できます。
参考:Qwen3: Think Deeper, Act Faster | Qwen
企業環境でローカルLLMが活躍するユースケースは
機密性を保ちながらAIの推論能力を活用できる特徴を活かし、様々な業務での導入が進んでいます。具体的な活用方法を整理します。
| 業務シーン | 活用方法 |
|---|---|
| 情報検索 | RAGを構築して社内ドキュメントやマニュアルを検索する |
| 会議の記録 | オフライン環境で議事録作成やテキスト要約を自動化する |
| 開発業務 | セキュアな環境下でエンジニアのコーディングを支援する |
RAGを構築して社内の機密ドキュメントや業務マニュアルを高速検索する
社内規定、過去の提案書、製品マニュアルなどの独自データをローカルLLMに読み込ませるRAGシステムの構築は、代表的な活用方法の1つです。社員が自然言語で質問すると、AIが膨大な社内データから該当箇所を探し出し、要約して回答します。外部のクラウドLLMに社内データをアップロードするリスクを冒さずに、情報検索の時間を大幅に短縮できます。
オフライン環境で会議の議事録作成やテキスト要約を自動化する
経営会議や未発表の新製品に関する打ち合わせなど、情報漏洩が許されない会議の音声をローカル環境でテキスト化し、要約させることができます。完全にインターネットから切り離されたオフラインのPC上で処理を完結させられるため、セキュリティポリシーが厳しい企業でもAIによる業務効率化の恩恵を受けられます。
【関連記事】
セキュアな環境下で開発エンジニアのコーディングを支援する
自社で開発中のソースコードは極めて重要な機密情報であるため、クラウド型のコーディング支援ツールの導入を禁止している企業も少なくありません。ローカルLLMを社内サーバーに構築して開発環境と連携させれば、ソースコードが外部に流出する心配なく、コードの自動生成やバグの発見、リファクタリングの提案といった支援を受けられます。
ゼロからの環境構築は不要!セキュアなAI議事録サービスの活用
ローカルLLMの実用的な性能を引き出すためには、高価なGPUの選定やサーバーの構築、継続的な保守運用といった高いハードルが存在します。しかし、「会議の議事録作成や要約」といったビジネス課題の解決が目的であれば、自社でゼロからAI環境を構築する必要はありません。
すでにローカルLLM技術が組み込まれた法人向けのAI議事録サービスを活用することで、導入の手間や初期費用を抑えつつ、セキュアで高性能なAI環境を素早く業務に取り入れることができます。
オフライン環境で完結するスタンドアローン型「ScribeAssist」
経営会議や未発表プロジェクトの打ち合わせなど、情報漏洩が一切許されない場面では、インターネット接続を必要としないスタンドアローン型のAI議事録作成ツール「ScribeAssist(スクライブアシスト)」が有力な選択肢になります。
高精度な音声認識から文字起こし、ローカルLLMによる要約までを完全にオフラインで完結させます。外部のクラウドサーバーへデータを送信しない構成のため、金融や医療など厳格なセキュリティポリシーを持つ企業でも安心して導入を検討できます。
セキュリティと業務効率化を推進するための資料ダウンロード
「ローカルLLMの性能には魅力を感じるが、自社構築のハードルが高い」「セキュリティ要件をクリアしながら議事録作成の手間を大幅に削減したい」とお考えの担当者様は、ぜひ具体的な機能や導入事例をご確認ください。
以下のリンクより、自社の業務フローに合わせた安全なAI活用をサポートする「ScribeAssist」の詳しい資料をダウンロードしていただけます。社内での比較検討や、スムーズなAI議事録の導入に向けた情報収集としてお役立てください。
▼資料ダウンロードはこちら
5分でわかる ScribeAssist | VoXT One(AmiVoice)
まとめ
ローカルLLMは、万能なクラウドLLMと異なり汎用的なタスクには限界があるものの、用途を絞ったチューニングやRAGと組み合わせることで実務に十分耐えうる性能を発揮します。機密情報を外部に出さずに済むセキュリティの高さと、利用回数に依存しないランニングコストの低さは、企業にとって大きな利便性をもたらします。導入にあたっては、実用的な応答速度を得るためにVRAM 12GB〜24GB以上のGPUを搭載したハードウェアを準備し、用途に合ったモデルを選定することが成功の鍵となります。
まずは自社のどの業務にAIを適用するのかを明確にし、必要な性能水準を見極めたうえで、モデルとハードウェアの選定に進むとよいでしょう。議事録作成や文書要約のように目的が明確な業務であれば、前章で紹介した「ScribeAssist」のようにローカルLLMを組み込んだ法人向けサービスの活用も選択肢になります。14日間の無料トライアルも用意されているため、実際の会議音声で性能を確かめながら比較検討してみてください。
問い合わせ
https://voxt-one.advanced-media.co.jp/inquiry/