ローカルLLMとRAGで社内AIを構築するには?必要なスペックと手順を解説
ローカルLLMとRAGの組み合わせは、情報漏洩リスクを抑えながら社内データを活用できるAI環境の構築に有効です。 導入のメリットから必要なPCスペック、具体的な構築手順までを一連の流れとして解説します。
ローカルLLMについて、こちらのコラムでもご紹介しています。
ローカルLLMとは?クラウド型との違いや導入メリットを解説!
この記事の要約
- クラウドを使わず社内でAIを動かすことで機密情報の漏洩リスクを大きく抑えられる
- 高性能なGPUやVRAMへの初期投資と、継続的な運用保守体制が必要になる
- LLMを快適に動かすにはVRAM4GB以上、RAM16GB以上のPCスペックが推奨される
- LM StudioやOllamaなどのツールを使い、社内環境で手軽に検証環境を作れる
- LLMのダウンロードから社内文書のベクトル化を経て業務システムと連携させる
目次
なぜローカルLLMとRAGを組み合わせるべきなのか
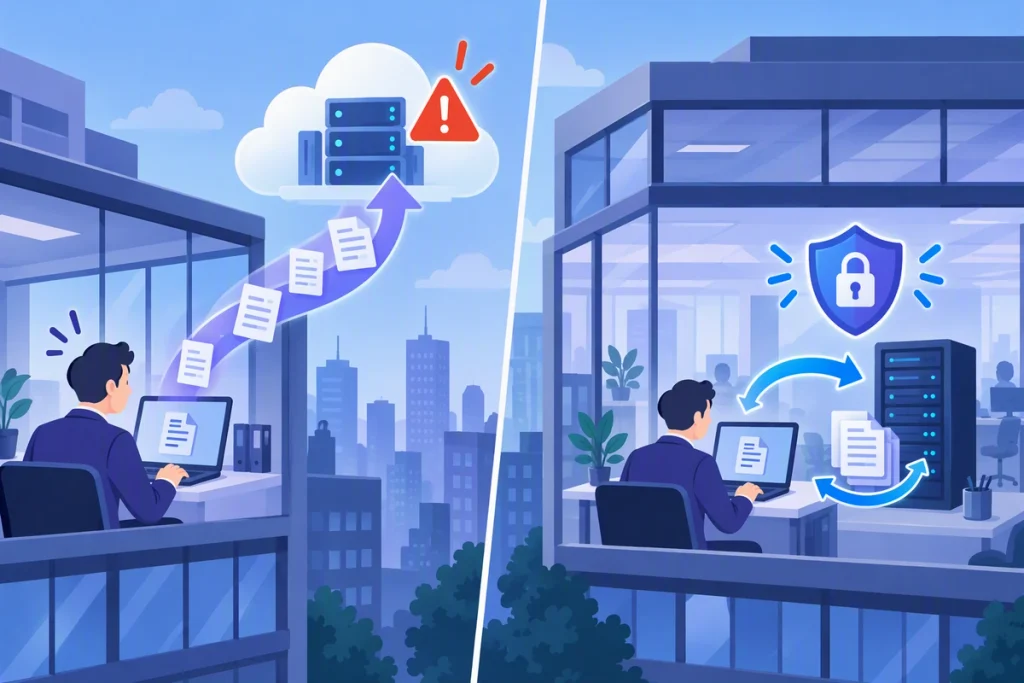
クラウドにデータを送信しないローカル環境でのAI実行は、機密情報を安全に扱うための効果的な選択肢です。企業がRAGとローカルLLMを組み合わせる利点を整理します。
| 導入の観点 | 具体的な利点 |
|---|---|
| 情報漏洩の防止 | データを外部サーバーに出さず完結する |
| コストの最適化 | API利用ごとの従量課金が発生しない |
| ネットワーク要件 | 外部通信が遮断された閉域網でも動く |
クラウド型AIが抱える情報漏洩リスクを排除できる
ローカル環境でAIを動かす利点の1つは、自社のデータを外部のサーバーに送信せずに済むことです。RAG(大規模言語モデルに外部の検索システムを組み合わせ、根拠となる情報を与えて文章を生成させる技術)をローカルで実行すれば、社外秘の設計図や顧客情報も安全に扱えます。クラウドサービスの利用規約やセキュリティポリシーを懸念する企業にとって、有効な選択肢といえます。
APIの従量課金を気にせず社内の機密文書を活用できる
社内PCのリソースを使って推論処理を行うため、LLMを利用するたびに発生する利用料を抑えられます。外部のAIサービスを利用して大量のドキュメントを読み込ませると、送信するデータ量に応じて課金されるケースが一般的です。ローカル環境であれば、毎日膨大なマニュアルを検索させてもランニングコストは膨らみません。
インターネットに接続できない閉域網でもシステムを運用できる
金融機関や医療機関など、インターネットから隔離されたネットワーク環境でも生成AIを導入できます。LLMのファイルや検索用のデータベースを社内のローカルサーバーに配置すれば、外部通信を一切必要とせずに動作することが特徴です。厳格なセキュリティ要件が定められている現場でも、AIによる業務効率化を進めやすくなります。
導入時に直面するローカルLLMのデメリット
セキュアなAI環境を構築できる一方で、ハードウェアへの初期投資や運用体制の確保が課題になります。導入を検討する際に知っておくべき注意点を解説します。
| 検討項目 | 想定される課題 |
|---|---|
| ハードウェア投資 | 処理用のGPUや大容量VRAMが必要になる |
| 回答の精度 | 最新のクラウド型巨大LLMに劣る傾向がある |
| 保守と管理 | モデルのライセンス確認やインフラ整備を自社で行う |
高性能なGPUや大容量のVRAMを用意するコストがかかる
ローカルLLMを実用的な速度で動かすには、グラフィックボードをはじめとする高価なPCパーツが必要です。とくに、LLMのデータを読み込むVRAM(グラフィックボードに搭載された専用のメモリ領域)の容量が不足すると、応答速度が著しく低下します。業務用のハイスペックな端末を人数分用意する場合、多額の初期費用が発生します。
クラウド上の最新巨大LLMと比べると回答精度が落ちやすい
手元のPCで動かせるサイズのLLMは、大規模な計算資源を前提とするクラウド上の最新LLMと比べると、複雑な推論能力に限界があります。社内文書を検索して要約するRAGの処理においても、文脈を正確に捉えきれず的外れな回答を返すケースも珍しくありません。業務で求める水準を満たせるか、事前に検証しておくことが重要です。
LLMのライセンス確認やインフラの保守管理を自社で行う必要がある
公開されているLLMを商用利用する際は、それぞれのライセンス形態を自社で確認する手間がかかります。また、ツールのバージョンアップやデータベースの保守管理も社内の担当者が担う領域です。クラウドサービスのように提供元がシステムを最新状態に保ってくれるわけではないため、運用負荷が高まる傾向にあります。
ローカルRAGの構築に必要なハードウェアのスペックは
LLMを実用的な速度で動かすには、GPUやメモリを中心とした十分なPCリソースが欠かせません。安定した推論環境を整備するための要件を示します。
| コンポーネント | 求められる役割と目安 |
|---|---|
| GPUとVRAM | 処理速度に影響し、専用VRAMは4GB以上を推奨する |
| CPUとメインメモリ | LLM実行を支え、RAMは16GB以上が望ましい |
| ストレージ | LLMデータを保存するため高速なSSDを活用する |
処理速度に直結するGPUとVRAMの容量を確保する
快適な応答速度を実現するには、NVIDIA製などの独立したGPUを搭載し、専用VRAMを最低でも4GB以上確保します。LLM全体をVRAM上に展開できるかどうかが、文字を出力するスピードを左右するためです。70億パラメータクラスの中型LLMを動かす場合でも、一定水準以上のグラフィック性能が求められます。
LLMの実行に適したCPUとメインメモリ(RAM)を用意する
GPUに処理を割り当てるシステム全体の制御や、検索システムの稼働には、十分なメインメモリ(RAM)が重要になります。ローカルLLMを安定して動かすのであれば、7Bクラスで最低8GB、13Bクラスで16GB、70Bクラスで64GB以上のRAMを搭載した環境が推奨されます。CPU自体の性能も、最新世代の処理能力を備えていることが望ましいです。
大規模なLLMデータを保存できるストレージ容量を確保する
数GBから数十GBにも及ぶLLMのファイル群を保存するため、ストレージの空き容量に余裕を持たせます。ファイルの読み書き速度もシステムの起動時間に影響することから、HDDよりも高速なSSDの利用が推奨されます。RAGで参照する社内文書の量が増えれば、データベース領域としてさらに数十GBの容量を消費します。
おすすめのローカルLLM・RAG関連ツール
ローカル環境でAIを動かし、自社データを検索対象に含めるためには、実行ツールとデータベースを組み合わせます。構築に役立つ主要なソフトウェアを紹介します。
| ツール名 | 主な用途と特徴 |
|---|---|
| LM Studio | LLMのダウンロードやチャット実行をGUIで行える |
| Ollama | デスクトップアプリとコマンドラインに対応しシステムへの組み込みに適する |
| LangChain | LLMと検索システムなどを連携させる開発用ライブラリ |
| ChromaDB | テキストをベクトル化して検索できるデータベース |
LM Studio
LM Studioは、画面上の直感的な操作だけでLLMをダウンロードし、チャットを実行できるソフトウェアです。複雑な初期設定なしでローカルLLMを試せるため、検証作業の第一歩としてよく利用されます。PDFなどを読み込ませて簡易的なRAG環境を手軽に構築できる点も強みです。
参考:LM Studio Bionic – Agent for Work and Code
Ollama
Ollamaは、コマンドラインを用いてLLMを効率的に起動・管理できるツールです。動作が軽量であり、APIを経由して他のアプリケーションから呼び出しやすい構造を持っています。開発者が自社の業務システムとLLMを連携させる際のバックエンドとして採用される傾向があります。
参考:Ollama
LangChain
LangChainは、LLMとさまざまな外部システムを接続するための開発用フレームワークです。LLMの回答に社内データベースの検索結果を組み合わせるなど、高度なRAGシステムを構築する際に中核的な役割を担います。プロンプトの管理や外部ツールの呼び出しを効率化できます。
参考:LangChain: the open agent platform to own your intelligence
ChromaDB
ChromaDBは、文章を数値化したデータを保存し、高速に検索するためのベクトルデータベースです。ベクトル化(文章の意味をAIが計算できる数値データの羅列に変換する処理)を行うことで、たとえば「社内規定」と「就業規則」という言葉が近い意味を持つと判定できます。RAGの実装において、ユーザーの質問に関連する情報を素早く探し出すために使われます。
参考:Chroma – open-source search infrastructure for AI
自社環境でローカルLLM RAGを検証・構築する手順
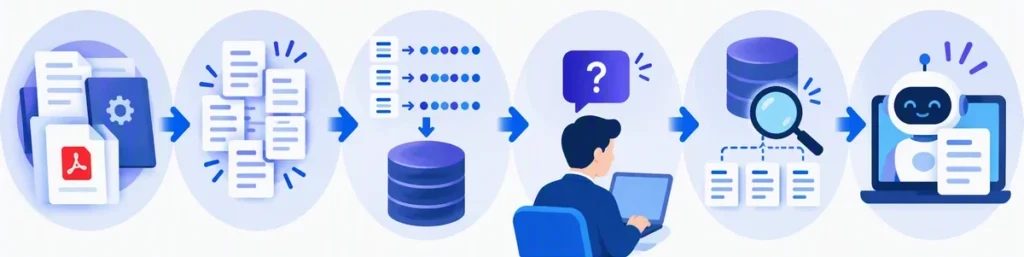
実際に社内のPCを使って、セキュアなAIを試作するための流れを段階的に説明します。
| 手順 | 作業内容 |
|---|---|
| 手順1 | OSに対応したLM StudioやOllamaをインストールする |
| 手順2 | VRAM容量に合ったサイズのLLMをダウンロードする |
| 手順3 | 社内文書を取り込みベクトルデータ化して保存する |
| 手順4 | テスト質問で文書を正しく参照できるか動作確認する |
| 手順5 | APIで既存の業務ツールや社内システムと連携させる |
手順1: 実行環境に合ったローカルLLMツールをインストールする
まずはPCのOS(WindowsやmacOSなど)に対応したLM StudioやOllamaをインストールします。ツールの公式サイトから実行ファイルをダウンロードし、画面の案内に従って初期設定を完了させる流れです。この段階で、使用するPCが最小要件を満たしているかも併せて確認します。
手順2: 搭載されたVRAMの容量に適したLLMをダウンロードする
インストールしたツールを経由して、手元のPCで動かせるサイズのLLMを取得します。VRAMの容量に合わせて、7B(70億パラメータ)や14B(140億パラメータ)といった適切な規模を選びます。処理の負荷を下げるためにデータサイズを圧縮した「量子化モデル」を選ぶのが一般的です。
手順3: 社内の機密文書を読み込ませベクトルデータ化する
RAGで参照させたいマニュアルや規程などの文書ファイルをツールに取り込みます。長い文章は意味のまとまりごとに細かい単位へ分割され、専用のLLMによってベクトルデータに変換される仕組みです。生成されたデータはChromaDBなどのデータベースに保存され、検索可能な状態になります。
手順4: 検索結果からAIが意図通りに回答を生成するか動作確認を行う
チャット画面からテスト用の質問を入力し、ローカルLLMがデータベース内の文書を正しく参照しているか確かめます。社内独自の用語やルールを踏まえた文章が生成されていれば、構築は成功です。期待した回答が返ってこない場合は、文書の分割方法(チャンクサイズ)を変えたり、より精度の高いLLMに変更したりと調整を繰り返します。
手順5: 既存の業務ツールや社内システムとAPIを連携させる
単体のチャットツールとしてではなく業務に組み込む場合は、Ollamaなどが提供するAPIを利用します。社内のチャットツールや独自のWebアプリケーションからローカルLLMを呼び出せるようにプログラムを記述する工程です。これにより、従業員が普段の業務フローの中で自然にAIを活用できるようになります。
セキュアなAI運用を「議事録・会議要約」からスモールスタートするには
ローカルLLMとRAGを用いた汎用的な自社AI基盤の構築は、自社データを安全に活用できる理想的な手段である一方、ハードウェアの選定やインフラの保守など、IT部門や情報システム担当者にとって運用負荷の高さがネックになりがちです。
そこで、まずは機密情報を扱う機会が多く、AIによる業務効率化の効果が見えやすい「会議の記録と要約」から導入を進めるのが現実的なアプローチです。アドバンスト・メディアが提供する音声認識AIプラットフォーム「VoXT One」では、自社のインフラ要件や運用体制に合わせて選べる2つのAIツールを提供しています。
【関連記事】
インターネット不要・完全オフラインで完結する「ScribeAssist」
経営会議や顧客情報を含むプロジェクトなど、データの外部送信が一切許されない業務には、スタンドアローン型の「ScribeAssist(スクライブアシスト)」が有力な選択肢となります。
PC内部に搭載したローカルLLMによって、文字起こしからAI要約までの全処理がオフラインで完結するため、外部送信に伴う情報漏洩のリスクを大幅に抑えられます。閉域網やLGWAN環境でもそのまま動作し、自社で高価なGPUサーバーを構築・保守する手間をかけずに、今すぐセキュアなAI要約環境を現場へ提供できるのが大きなメリットです。
【関連記事】ローカルLLM搭載!オフラインでAI要約までセキュアに使える高精度なAI議事録ツールとは【LLMの解説付き】 | コラム | VoXT One(AmiVoice)
活用事例:株式会社横浜フィナンシャルグループ
株式会社横浜フィナンシャルグループでは、会議の議事録作成にあたり、役職者が長時間をかけて文字起こしを行っており、業務負担の大きさが課題となっていました。一方で、会議内容には機密情報が含まれるため、インターネット経由で情報をやり取りするクラウド型のシステムには抵抗がありました。
そこで採用したのが、パソコン内で処理が完結するスタンドアローン型の「ScribeAssist」です。インターネット回線を介さないため、情報漏洩リスクを抑えながら音声認識を活用できる点が決め手となりました。
導入後は、会議の音声ファイルを簡単な操作でテキスト化できるようになり、文字起こしに要する時間が大幅に短縮されました。さらに、会議中の発言をリアルタイムで音声認識させることで、会議の終了と同時にテキスト化も完了します。会議直後に討議内容を把握でき、論点の確認をすぐに行えることも大きな効果となっています。
自社の要件に最適なAIツールを見つけるために
「自社のセキュリティポリシーにはどちらのシステムが適しているか」「ローカル環境とクラウド環境で機能やコストにどのような違いがあるのか」など、社内での要件定義や決裁をスムーズに進めるための比較資料をご用意しています。
両サービスの具体的な機能比較や、導入による業務時間の削減シミュレーションをご担当者様向けに分かりやすくまとめた資料となっております。情報漏洩リスクを排除した安全な社内AI活用の第一歩として、ぜひ以下のリンクからダウンロードしてご活用ください。
▼無料資料のダウンロードはこちら
「5分でわかる ScribeAssist・ProVoXT」資料ダウンロード
まとめ
ローカルLLMとRAGを組み合わせれば、社内の機密文書を外部に送信せずにAIを活用しやすくなります。導入にあたっては、自社のVRAMやGPUなどのハードウェア要件を明確にし、LM StudioやOllamaなどの実行ツールを適切に選定して構築を進めます。
一方で、全社展開を前提にすると、GPU調達やモデル更新、精度検証を自社で担い続ける負荷は小さくありません。まずは効果が見えやすい業務単位でローカルLLMを実装し、自社構築と既製ツールを併用する形から始めるのが現実的です。
議事録作成のように機密情報を扱う頻度が高い業務であれば、ローカルLLM要約をあらかじめ備えたツールを使う方が、早く成果に結びつきやすくなります。アドバンスト・メディアの「ScribeAssist」では、PC内で文字起こしから生成AI要約まで完結するため、閉域網やLGWAN環境でもインフラを新設せずに運用できます。14日間のトライアルで、自社の会議音声と社内用語でどこまで精度が出るかを検証できます。