ローカルLLMのデメリットとは?メリットとの違いや現実的な導入策
ローカルLLMは情報漏えいリスクを防げる一方で、初期費用や運用保守の負担といったデメリットが存在します。本記事では、クラウド型LLMとの違いをはじめ、導入前に知っておくべきメリット・デメリット、自社構築の手順を解説します。
ローカルLLMについて、こちらの記事でもご紹介しています。
ローカルLLMとは?クラウド型との違いや導入メリットを解説!
この記事の要約
- データを外部に送信しないため、機密性の高い情報を扱う業務と相性が良い
- サーバーなどの初期費用や、運用保守を担う専門人材の確保が課題となる
- モデルの性能や拡張性は、自社で用意したハードウェアのスペックに依存する
- 導入のハードルを下げるには、ローカルLLM搭載のパッケージ製品も有効である
- 議事録作成や顧客データ分析など、セキュリティ要件が厳しい領域で活躍する
目次
ローカルLLMとは?クラウド型との決定的な違い
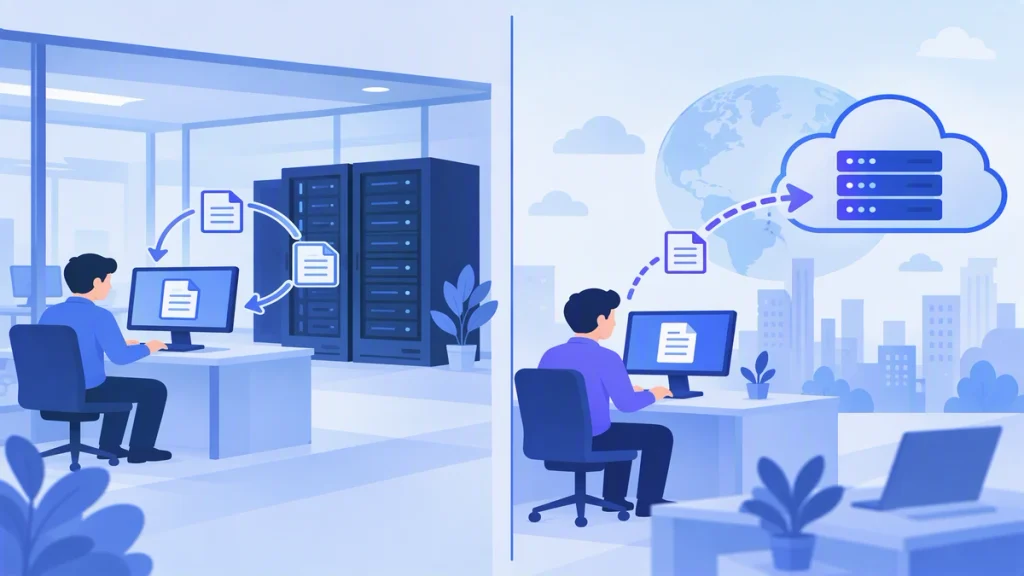
ローカルLLMとクラウド型LLMは、処理を実行する場所とコストの発生タイミングに違いがあります。自社のセキュリティ要件や予算に応じて適切な方式を選びます。
| 比較項目 | ローカルLLM | クラウド型LLM |
|---|---|---|
| 処理の実行場所 | 自社内のサーバーやPC | ベンダーの外部サーバー |
| コストの発生時期 | ハードウェアなどの初期投資 | 利用量に応じた従量課金 |
処理を実行する場所が外部サーバーか自社環境かで分かれる
ローカルLLMは、自社が管理するPCや社内サーバーに言語モデルをダウンロードして実行します。インターネット経由でベンダーのサーバーにデータを送信するクラウド型とは異なり、社内で処理が完結します。
コストの発生タイミングが継続的か初期投資かで異なる
ローカルLLMは初期段階でハードウェアの調達にコストが集中します。クラウド型はAPIの利用量やユーザー数に応じた月額費用が継続的に発生するため、運用期間が長くなるほど総コストの逆転が起こり得ます。一方で、ローカルLLMでも電気代や保守費用はかかり続けるため、維持費が完全に無料になるわけではありません。
導入前に把握すべきローカルLLMのデメリット
機密性の高さが魅力のローカルLLMですが、導入にはコストと技術力の壁が立ちはだかります。代表的な4つの課題を整理します。
| デメリットの観点 | 具体的な懸念点 |
|---|---|
| ハードウェア費用 | 高性能なGPUやサーバーの調達に多額の初期投資が必要 |
| 運用保守の負担 | 定期的なモデル更新や障害対応を自社で行う必要がある |
| 性能と拡張性の限界 | 用意したハードウェアの処理能力を超える対応が難しい |
| 技術的な難易度 | 環境構築やチューニングに専門知識を持つ人材が不可欠 |
高性能なGPUなどハードウェアの初期費用が高額になる
大規模な言語モデルを実用的な速度で動かすには、計算能力の高いGPU(画像処理半導体)を搭載したサーバーが必要になるのが一般的です。高性能なGPUは数百万円単位の投資になることもあり、予算確保が最初のハードルとなります。
専門知識を持つ人材の確保や運用保守の負担が大きい
システムが稼働したあとも、モデルのアップデートやセキュリティパッチの適用を自社で管理する必要があります。クラウド型のようにベンダーが自動で保守してくれないため、AIやインフラに精通したエンジニアの継続的なリソースが求められます。
モデルの性能や拡張性に物理的な限界がある
ローカルLLMの処理能力は、導入したサーバーのスペックに依存します。利用者が急増して処理が追いつかなくなった場合、クラウド型のようにボタン一つでリソースを拡張できず、新たなハードウェアの追加手配を待つことになります。
環境構築やファインチューニングの技術的難易度が高い
業務に合わせた独自の回答を生成させるためのファインチューニング(追加学習)には、高度なノウハウが必要です。パラメーターの調整を誤るとかえって回答の精度が下がるリスクもあり、試行錯誤に時間と工数を奪われます。
デメリットを上回るローカルLLMのメリット
高い導入ハードルを越えてでもローカルLLMを選ぶ企業が増えているのは、クラウド型では得られない確かな見返りがあるからです。主な4つのメリットを説明します。
| メリットの観点 | 期待できる効果 |
|---|---|
| 情報セキュリティ | 外部へのデータ送信がなく情報漏えいリスクを遮断できる |
| 応答速度と安定性 | ネットワーク遅延の影響を受けずオフラインでも機能する |
| ランニングコスト | APIの従量課金が発生せず長期的にはコストを抑えやすい |
| カスタマイズ性 | 自社の独自データに特化した専用モデルを構築できる |
外部にデータを送信しないため情報漏えいリスクを抑えられる
入力したデータを社内ネットワーク内で処理できるため、機密情報を扱いやすくなります。クラウド型LLMの規約で「学習に利用しない」と明記されていても不安が残るような、極めてセンシティブなデータも気兼ねなく入力できます。
通信遅延が発生せず即時応答やオフライン環境での利用ができる
インターネットを介さずに推論処理を行うため、通信環境によるタイムラグが生じません。工場の生産ラインや通信が遮断された研究施設など、完全なオフライン環境でも生成AIの恩恵を受けられます。
API利用料などの従量課金を回避しランニングコストを削減できる
大量のテキストデータを処理する場合でも、外部APIへのリクエスト費用が発生しません。全社員が日常的にAIを活用して使用量が膨大になるケースでは、数年単位で見るとクラウド型よりも安価に運用できる場合があります。
自社の独自データを用いて社内専用のモデルへカスタマイズできる
LLMの内部構造に直接手を入れることができます。特定の業界用語や社内規定を深く学習させ、一般的なAIでは回答できない専門的な業務に特化したアシスタントを作り上げられます。
どんな業務でローカルLLMを選ぶべきか
メリットとデメリットを踏まえると、ローカルLLMの真価が発揮される場面はおのずと絞られます。適した業務シーンを提示します。
| 適用シーン | 選定の理由 |
|---|---|
| 機密情報の処理 | 外部送信が許されないデータを扱うため |
| 閉域網での運用 | インターネット接続が制限されているため |
経営会議の議事録や顧客データなど機密性の高い情報を扱う
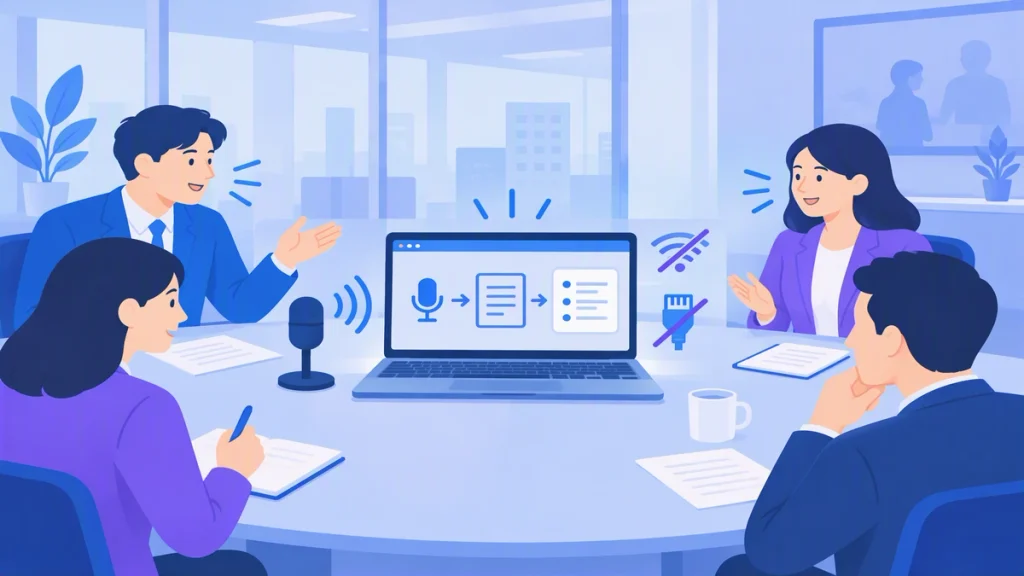
未公開の財務情報や個人情報を含むドキュメントを要約・分析する業務に適しています。たとえば、役員会議の音声データをローカル環境のAIで文字起こしして要約すれば、外部送信に伴う情報漏えいのリスクを大きく抑えられます。
インターネット接続が制限された閉域網やエッジ環境でAIを利用する
セキュリティポリシーにより外部通信を遮断している金融機関の基幹システムや、IoT機器の制御を行うエッジ環境と相性が良いです。通信を必要としない独立した環境で、リアルタイムな推論処理を実行できます。
議事録業務でローカルLLMを使う場合に必要な要件
機密情報を扱う業務のなかでも、会議の議事録作成はローカルLLMのニーズが特に高い領域です。自社構築を検討する前に押さえておきたい要件を整理します。
| 要件 | 確認すべき内容 |
|---|---|
| 音声認識の処理場所 | 文字起こしを行うエンジンもローカルで動作するか |
| 要約処理の完結性 | 生成AIの推論をPC内部で実行できるか |
| ネットワーク条件 | 閉域網やオフライン環境で機能が制限されないか |
音声認識と要約の両方をオフラインで完結させる構成が求められる
議事録作成では、ローカルLLMによる要約だけでなく、その前段にある音声認識も社内で処理する必要があります。要約はローカルで動かせても文字起こしを外部のクラウドAPIに依存していれば、音声データが社外に出てしまい、情報漏えいリスクを遮断できません。会議音声の録音、文字起こし、要約、出力までを一貫してオフラインで処理できる構成かどうかを、要件定義の段階で確認します。
LGWANなどの閉域網では専用アプリケーションの採用が近道になる
自治体のLGWAN環境や金融機関の基幹ネットワークのように外部通信が遮断された環境では、モデルの取得やライブラリの更新そのものが制限され、自社構築の難易度がさらに上がります。こうした環境では、インストール後にインターネット接続を前提としないスタンドアローン型のアプリケーションを選ぶほうが、セキュリティポリシーを維持したまま短期間で運用を始められます。
注目されている日本語対応のローカルLLMモデル
ローカルLLMを構築するベースとして、日本語に強く実用的なモデルが続々と公開されています。代表的な4つのモデルの特徴を比較します。
| モデル名 | 主な特徴 |
|---|---|
| Gemma 3 | Googleが公開する軽量かつ高性能な多言語対応モデル |
| Qwen2.5-7B-Instruct | バランスに優れ業務アプリとの連携に向くモデル |
| Llama-3.1-70B-Japanese-Instruct-2407 | 高性能な反面、高いハードウェア要件を求める |
| Qwen3 Swallow | 日本語能力と思考力を強化した国内開発の推論型モデル |
Gemma 3
Googleが開発したオープンモデルであり、複数言語への対応と軽量さを両立しています。PC程度のスペックでも動作するサイズのモデルが用意されており、ローカルLLMの導入検証を手軽に始めたい企業に適しています。
Qwen2.5-7B-Instruct
長文のコンテキストを理解し、表などの構造化データの理解や、JSONなどの構造化出力に強みがあります。既存の業務アプリケーションとLLMを連携させ、定型業務を自動化するような用途で強みを発揮します。
参考:Qwen/Qwen2.5-7B-Instruct · Hugging Face
Llama-3.1-70B-Japanese-Instruct
サイバーエージェントが公開した、Metaの「Llama 3.1 70B Instruct」をベースに日本語の継続事前学習を行った高性能モデルです。自然で流暢な日本語を生成できますが、モデルサイズが巨大なため、本格的なサーバー環境と潤沢なGPUリソースが求められます。
参考:cyberagent/Llama-3.1-70B-Japanese-Instruct-2407 · Hugging Face
Qwen3 Swallow
東京科学大学の岡崎研究室・横田研究室と産業技術総合研究所の研究チームが、Qwen3をベースに日本語能力と思考力を強化した推論型のモデルです。8Bから32Bまでのサイズが公開されており、日本語特有のニュアンスを捉えた生成と、手元の計算資源に合わせた選択を両立できます。
参考:Qwen3 Swallow — Swallow LLM
自社でローカルLLMを構築する際の基本的な手順
実際にローカル環境へLLMを導入するには、入念な計画と技術的なステップを踏む必要があります。構築の大きな流れを整理します。
| 構築フェーズ | 実施内容 |
|---|---|
| 要件定義と調達 | 必要な計算リソースを算出しサーバーを用意する |
| モデル選定と導入 | 用途に合うモデルをダウンロードし環境に配置する |
| 設定とテスト | ソフトウェアを構成し動作確認と調整を行う |
目的に合わせたハードウェア要件を定義し計算資源を調達する
扱うデータの量や求める応答速度から、必要なGPUの性能とメモリ容量を逆算します。将来のモデル大型化を見据え、ギリギリのスペックではなく余裕を持ったハードウェア構成でサーバーを調達します。
タスクに適したオープンソースのAIモデルを選定しダウンロードする
要約、翻訳、プログラム生成など、解決したいタスクを得意とするモデルを選びます。利用規約やライセンスを確認したうえで、Hugging Faceなどのプラットフォームから安全にモデルデータを取得します。
実行環境やソフトウェアを設定し段階的にテスト運用を進める
モデルを動かすためのフレームワークやライブラリをインストールし、実行環境を整えます。まずは小規模なデータで応答品質や処理速度をテストし、問題がなければ徐々に対象業務を広げていきます。
構築のハードルを下げてローカルLLMを導入するための選択肢
自社でゼロから環境を立ち上げるのが難しい場合でも、ローカルLLMの恩恵を受ける方法はあります。現実的な2つのアプローチを紹介します。
| 導入の選択肢 | 解決できる課題 |
|---|---|
| パッケージ製品の活用 | 構築の手間と初期費用を大幅に削減できる |
| 外部ベンダーの支援 | 専門人材の不足を補い安定運用を実現する |
一から構築せずローカルLLM搭載のパッケージ製品を活用する
あらかじめローカルLLMが組み込まれた業務用のソフトウェアやアプライアンス製品を導入します。サーバーの選定や環境構築が不要になるため、自社に専門のエンジニアがいなくても、安全なAI環境を短期間で手に入れられます。製品を選ぶ際は、「要約や推論の処理がPC内部で完結するか」「インターネット接続が切れた状態でも機能が制限されないか」「LGWANなどの閉域網に対応しているか」の3点を確認します。
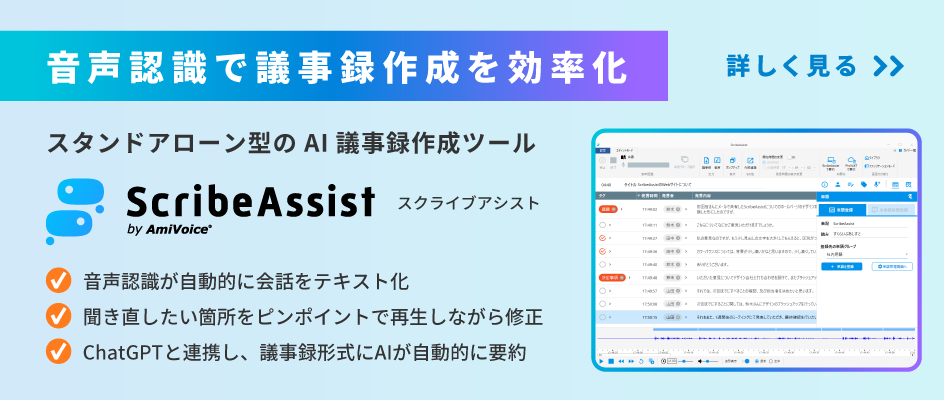
たとえばアドバンスト・メディアの「ScribeAssist(スクライブアシスト)」は、AI音声認識AmiVoiceによる文字起こしから生成AIによる要約までをPC内部(オフライン環境)で完結させる「スタンドアローン要約」を備えています。そのため、GPUサーバーの調達やモデル選定を行わずにオフライン環境での運用を始められます。同社の議事録作成支援サービスは自治体で990件、民間企業・団体で2,100件の導入実績があり、機密性の高い会議記録から段階的に適用範囲を広げる進め方が可能です。
環境構築や運用保守を包括的にサポートする外部ベンダーの支援を受ける
ハードウェアの調達からモデルのチューニング、稼働後の保守までを専門業者に委託します。初期費用はかかりますが、自社のインフラ担当者の負担を抑えつつ、確実なセキュリティ対策と安定したシステム稼働を両立できます。
【関連記事】
構築・運用の課題をクリアし、セキュアな環境を実現する「ScribeAssist」
ローカルLLMは情報漏えいリスクを防ぐ強力な手段ですが、ここまでに解説した通り、自社構築には高額な初期費用や専門人材の確保といった「ローカルLLMならではのデメリット」が立ちはだかります。
「セキュリティは妥協できないが、一からインフラを構築・維持するリソースはない」とお悩みの情報システム担当者様やDX推進部門の皆様に現実的な解決策となるのが、株式会社アドバンスト・メディアが提供するスタンドアローン型のAI議事録ツール「ScribeAssist」です。
完全オフラインで機密情報を守る「ScribeAssist」
「ScribeAssist」は、ローカルLLMを搭載したスタンドアローン型のアプリケーションです。インターネット接続がない完全なオフライン環境でも、国内で豊富な導入実績を持つAI音声認識による高精度な文字起こしから、ローカルLLMを用いたスタンドアローン要約までがご利用のPC内部だけで完結します。
高額なGPUサーバーの調達や、複雑なAIの環境構築といったローカルLLMのデメリットを回避できる点が大きなメリットです。経営会議や人事面談など、データを社外へ出せない機密性の高い業務であっても、導入後すぐに生成AIの活用を始められます。
活用事例:社会医療法人誠光会 淡海医療センター・淡海ふれあい病院
社会医療法人誠光会 淡海医療センター・淡海ふれあい病院では、インターネット回線を介した情報漏洩リスクが生じない点を評価し、パソコン内で処理が完結するスタンドアローン型のAI議事録ツール「ScribeAssist」を導入しました。
その効果は、1件あたり3〜4時間かかっていた議事録作成が約1時間に短縮され、月間では約7割の削減につながるほど。「下書きを確認して微調整するだけで済むため、精神的な負荷も大きく軽減した」と実感されています。
自社に最適なAI議事録の導入に向けて
「自社でローカルLLMを構築するのは現実的ではない」と結論づけた場合でも、用途に合ったパッケージ製品を活用すれば、厳しいセキュリティ要件とコストパフォーマンスを両立させることが十分に可能です。
・実際の操作画面や詳細な機能、具体的な料金体系はどうなっているか?
・社内稟議を通すための具体的なコスト削減シミュレーションが見たい
こうした検討をスムーズに進めるための詳しい情報は、以下のリンクより無料でダウンロードいただけます。自社のAI活用プロジェクトを前進させる第一歩として、ぜひお気軽にご活用ください。
▼機能詳細や料金プラン、導入事例がわかる資料はこちら
資料ダウンロード(無料) | VoXT One
まとめ
ローカルLLMは、外部にデータを送信しないセキュリティ環境を構築しやすい一方で、高額な初期投資と専門人材による運用保守が課題となります。導入の際は、機密性の高い議事録や顧客データの処理など、クラウド型では対応できない明確な用途があるかを見極めることが重要です。
しかし、多くの企業にとって自社でゼロからAIインフラを構築・維持することは、技術的にもコスト的にも容易ではありません。セキュリティを担保しながらも、導入のハードルを下げていち早く業務効率化を進める手段を見つけることが、成功の鍵を握ります。情報漏えいを防ぎつつAIを活用したい場合は、ローカルLLMを搭載した専用ツールの導入が現実的な解決策になります。
アドバンスト・メディアが提供する議事録プラットフォーム「VoXT One」のスタンドアローン型アプリケーション「ScribeAssist」は、文字起こしからローカルLLMによる要約までをオフラインで完結でき、機密性の高い会議でも安全に議事録作成を効率化できます。自社構築とパッケージ製品のどちらが現実的かを見極める段階であれば、14日間の無料トライアルで実際のPC環境における処理速度と要約品質を検証できます。稟議用の資料や費用試算が必要な場合も、あわせてご相談ください。